
AI活用・組織づくり
Jevとは?公式情報からわかる仕組み・使い方・導入判断
Jevとは何かをTypeSafe AIの公式情報に基づいて解説。公式サイト、仕組み、APIの使い方、LLMとの違い、料金・注意点、企業が導入を判断する基準まで整理します。
加藤 貴志
MANAGEWORKS株式会社 代表取締役
こんな方へ:JevやSystem One Modelの仕組みと実務上の使いどころを知り、自社のAI自動化へ導入すべきか判断したい経営者・事業責任者・開発責任者
この記事の要点
- Jevは文章を生成せず、Choice・Score・Noulの型付き判断と確率を返す
- 高速・低価格は魅力だが、型の保証と判断の正しさは分けて検証する
- 導入時は判断工程を分解し、確信度と業務リスクに応じて人へ戻す
Jevとは、TypeSafe AIが提供する、文章生成ではなく分類・採点・真偽判定などの「判断」に特化したAIモデルです。公式サイトとドキュメントではSystem One Modelの第1号として紹介されており、利用にはearly accessへの登録が必要です。公式情報はTypeSafe AIのJev紹介ページで確認できます。
この記事では、Jevの仕組みと使い方、生成AIとの違い、企業が導入前に確認すべき精度・費用・人による確認設計まで、公式情報を基に判断できる形で整理します。
Jevとは、文章ではなく「判断」を返すAIモデル
Jev(ジェブ)とは、TypeSafe AIが2026年9月15日に公開した、ソフトウェア内の判断に特化したAIモデルです。同社が「System One Model」と呼ぶ新しいモデル群の第1号で、入力された文章やJSONなどの状態を読み、あらかじめ定義した選択肢、採点、真偽の確率を返します。
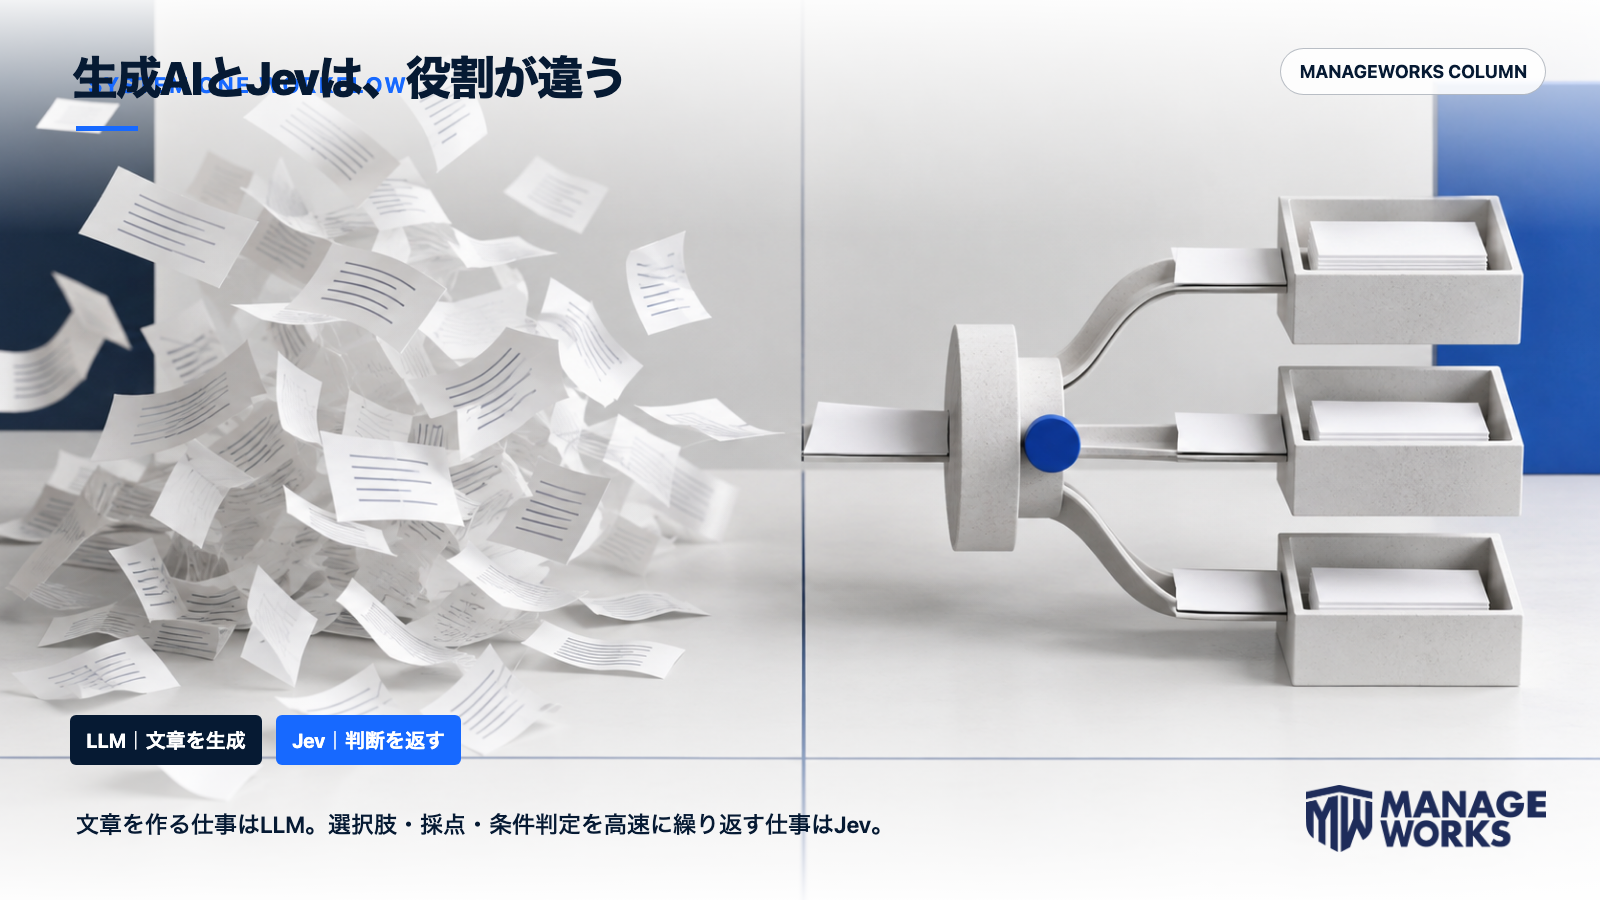
ChatGPTなどの大規模言語モデル(LLM)のように文章を書いたり、コードや説明を生成したりするモデルではありません。問い合わせを担当部署へ振り分ける、緊急度を採点する、条件に合うかを判定するといった、答えの型を先に決められる仕事に向きます。
ただし、Jevが新しいからといって既存の生成AIをすぐ置き換えるものではありません。重要なのは、文章生成と判断を分け、業務のどこに速い判断が必要か、誤った場合に人へ戻せるかを設計することです。
Jevと生成AI・LLMの違い
LLMは文字列を順番に生成するため、相談への回答、要約、記事、コードなど柔軟な出力が得意です。一方、Jevは出力候補を事前に固定し、型付きの値と確率分布を返します。ソフトウェア側は返答文を再解析せず、値をそのまま条件分岐、並べ替え、ルーティングに使えます。
TypeSafe AIの公式資料では、System One Modelの入力を「state」、問いを「typed questions」と表現しています。現時点のJevはテキスト入力のみで、文字列、JSONオブジェクト、テキスト配列を評価できます。画像、音声、動画には対応していません。
Jevが返す3種類の判断
Choice:定義した候補から一つを選ぶ
問い合わせを「請求」「技術」「営業」に分類するような用途です。選ばれた項目だけでなく、候補ごとの確率とconfidence(確信度)が返ります。公式発表では選択肢の上限を255としています。
Score:段階評価する
顧客の不満度、案件の優先度、文章の品質などを、2〜10段階の基準で評価します。単なる整数ではなく、各段階の確率から算出された連続値と確信度を取得できます。
Noul:真偽の確率を返す
「この問い合わせは返金を求めているか」「この文章は緊急性を示すか」のような命題に対し、0〜1の値を返します。名称は同社独自ですが、実務上はYes/Noの確率判定として理解すると分かりやすいでしょう。
三つの問いは一つのAPI呼び出しで混在でき、同じstateに対して独立かつ並列に評価されます。問いを増やしても互いの回答を文脈として参照しないため、複数観点を分けて判定し、最後に通常のコードで統合する設計が基本です。
速さと価格は魅力だが、公式値の条件を読む
TypeSafe AIは、Jevの応答時間を70〜500ミリ秒、料金を入力100万トークンあたり0.042ドル、出力は無料と公表しています。また、同社のワークフロー評価を根拠に、既存LLMより最大193.6倍高速、444.6倍低コストと訴求しています。
これらはJevに適した「System One型の問い」における同社測定です。同社自身も、公開評価は米国西海岸からの実行であること、比較用stateが短く密度の高い文章でJevに有利であること、ワークフロー評価をモデル能力チームが作成したため偏りの可能性があること、速度・費用の倍率は実運用で得られる改善の上限寄りだと説明しています。
したがって、導入判断では宣伝上の倍率をそのまま自社へ当てはめず、同一の入力、判断基準、正解データ、通信条件で既存手法と比較する必要があります。Jevは現在early accessであり、仕様や価格が変わる可能性も考慮します。
「ゼロ・ハルシネーション」は判断ミスがゼロという意味ではない
TypeSafe AIは、Jevが定義外の文章や値を生成しないことを「Zero Hallucinations」と表現しています。出力形式がスキーマに一致し、型エラーを起こさないことは、ソフトウェアへ組み込むうえで大きな利点です。
しかし、型が正しくても選択や採点を誤る可能性はあります。公式ドキュメントも、確率の校正は予測群全体で測る性質であり、個別回答の正しさを保証しないと明記しています。高い確率を返した一件が必ず正しいわけではありません。
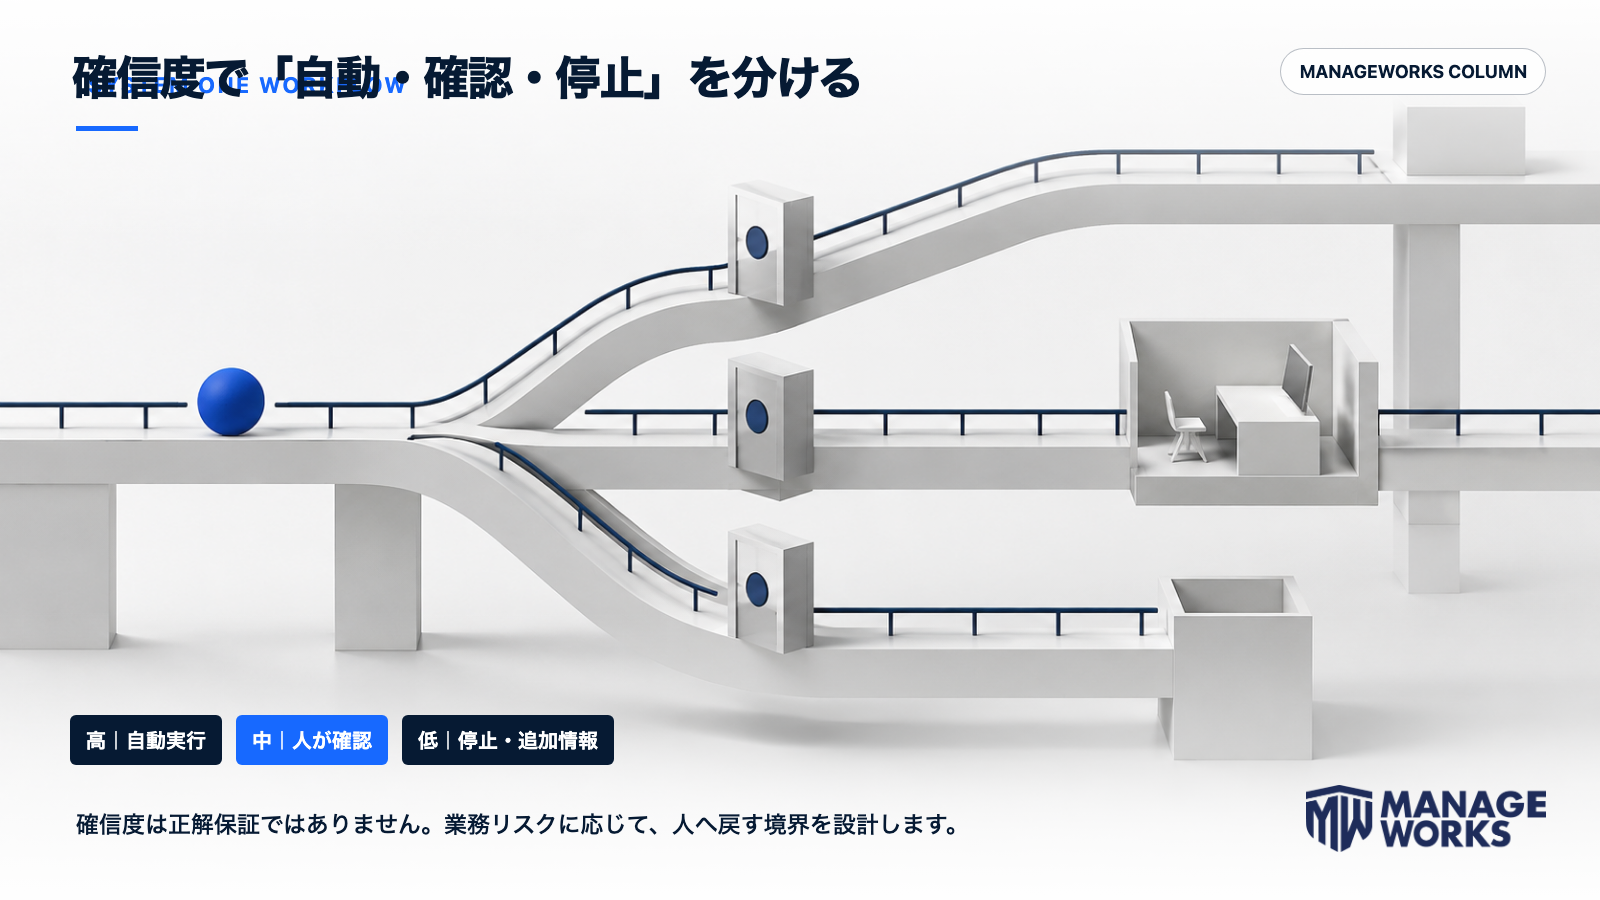
低リスクの画面表示なら低めの閾値で自動化できても、返金、契約、与信、医療・法務に関わる判断は、人の確認や別ルールを組み合わせるべきです。確信度の低い案件を人へ戻し、その記録を検証データとして蓄積する運用が欠かせません。
Jevが向く業務と、向かない業務
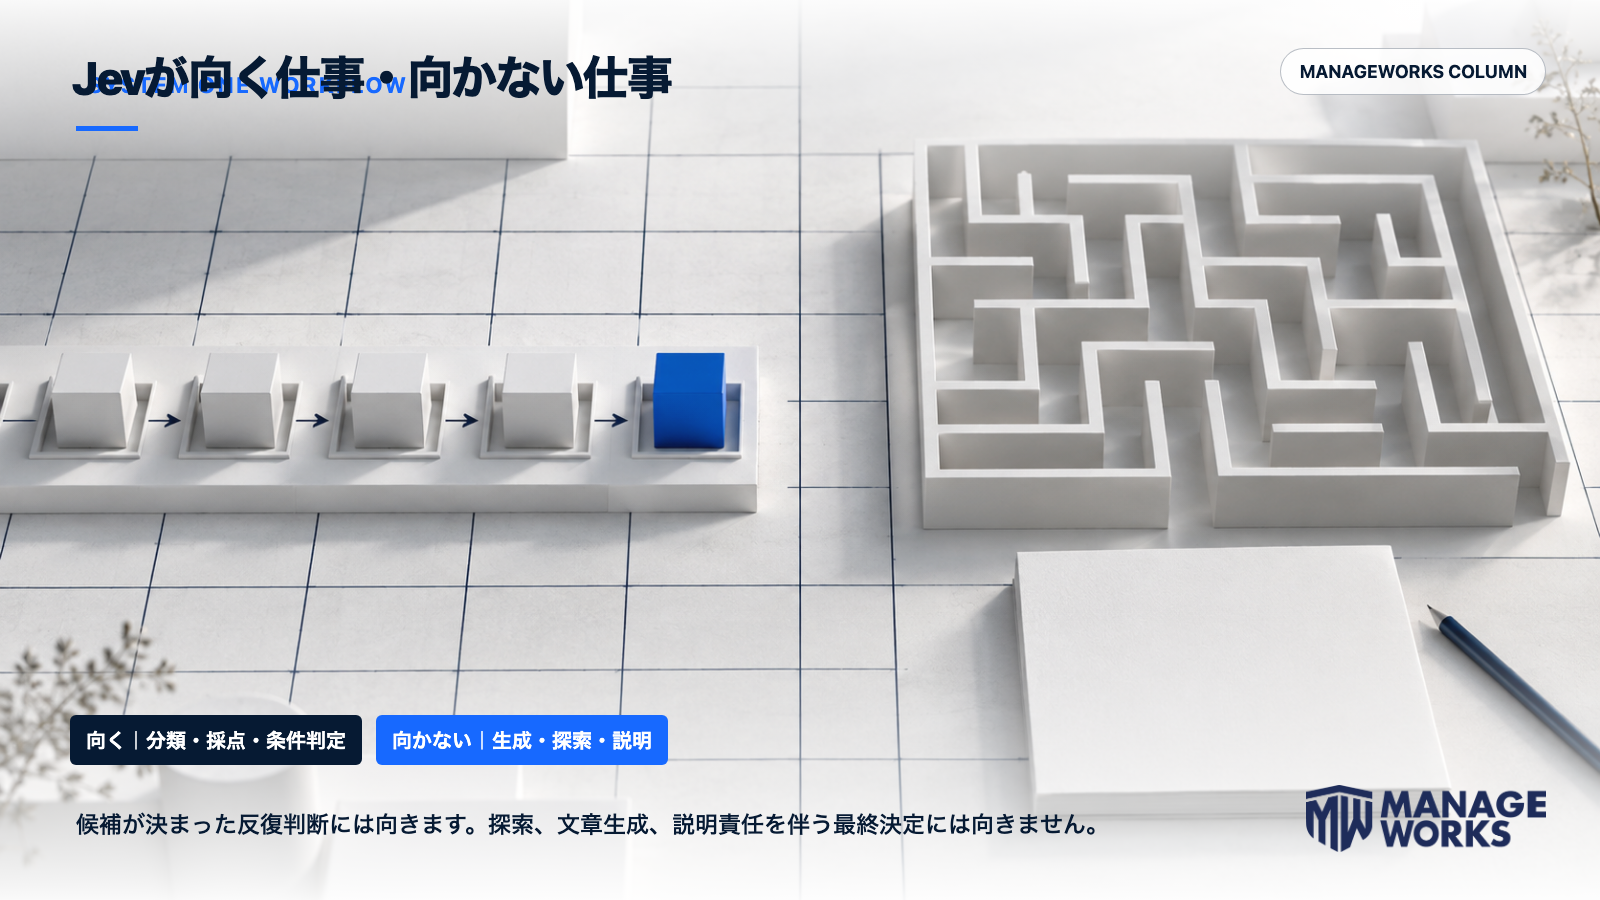
向くのは、候補が定義でき、同じ基準で大量に繰り返し、速度や費用がボトルネックになる判断です。例として、問い合わせ分類、意図判定、優先度採点、審査前の振り分け、コンテンツ検査、LLM出力の評価、顧客の解約予兆や次の接点の候補判定が考えられます。
一方、説明文の作成、顧客との対話、企画立案、コード生成、根拠の文章化、複数の価値判断を長く比較する仕事には向きません。入力に答えが含まれない判断、候補を事前に定義できない探索、高い説明責任がある最終決定も、Jev単体へ委ねない方が安全です。
導入は「AIを入れる」より判断工程の分解から始める
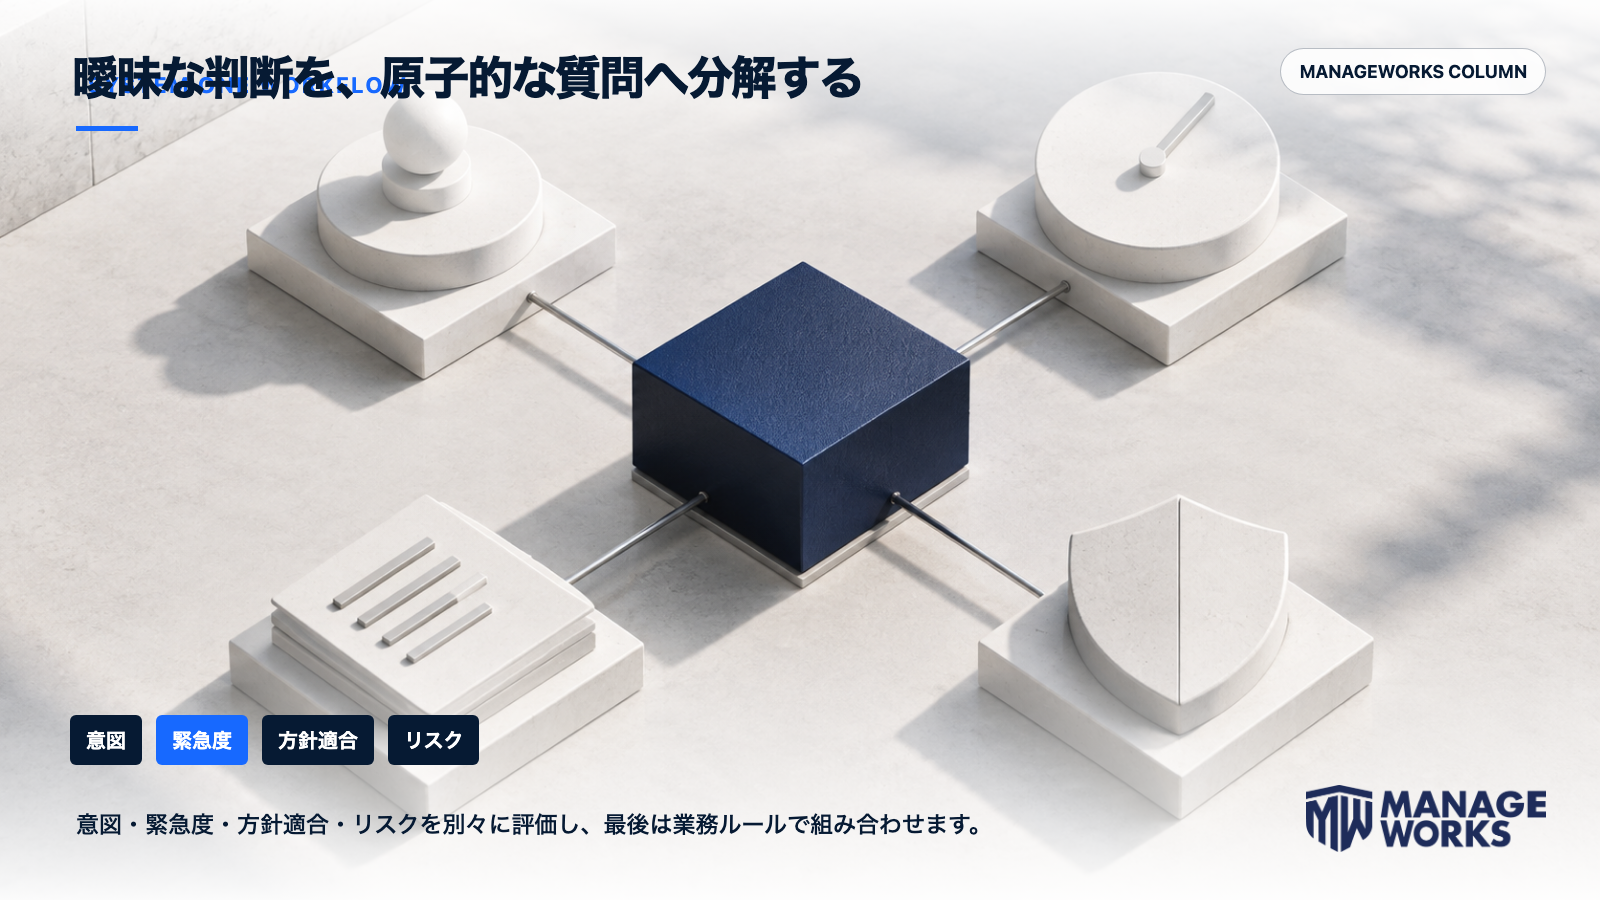
公式ドキュメントは、一つの問いを原子的で範囲の狭い判断にすることを推奨しています。たとえば「この顧客にどの施策を行うべきか」を一問で尋ねず、購入段階、利用状況、問い合わせ意図、緊急度、方針適合、リスクを別々に評価し、自社のルールで重み付けします。
- 対象判断を一つ選ぶ:件数、所要時間、誤判定コストが測れる工程に絞る
- 正解と例外を定義する:候補、評価基準、人へ戻す条件を現場と合意する
- 問いを分解する:一つの質問に複数の観点を混ぜない
- 自社データで比較する:正答率だけでなく、確信度別の精度、速度、費用、確認工数を測る
- 運用責任を決める:閾値変更、誤判定レビュー、モデル更新時の再検証を担当化する
Jevの導入方法:APIを動かすまでの手順
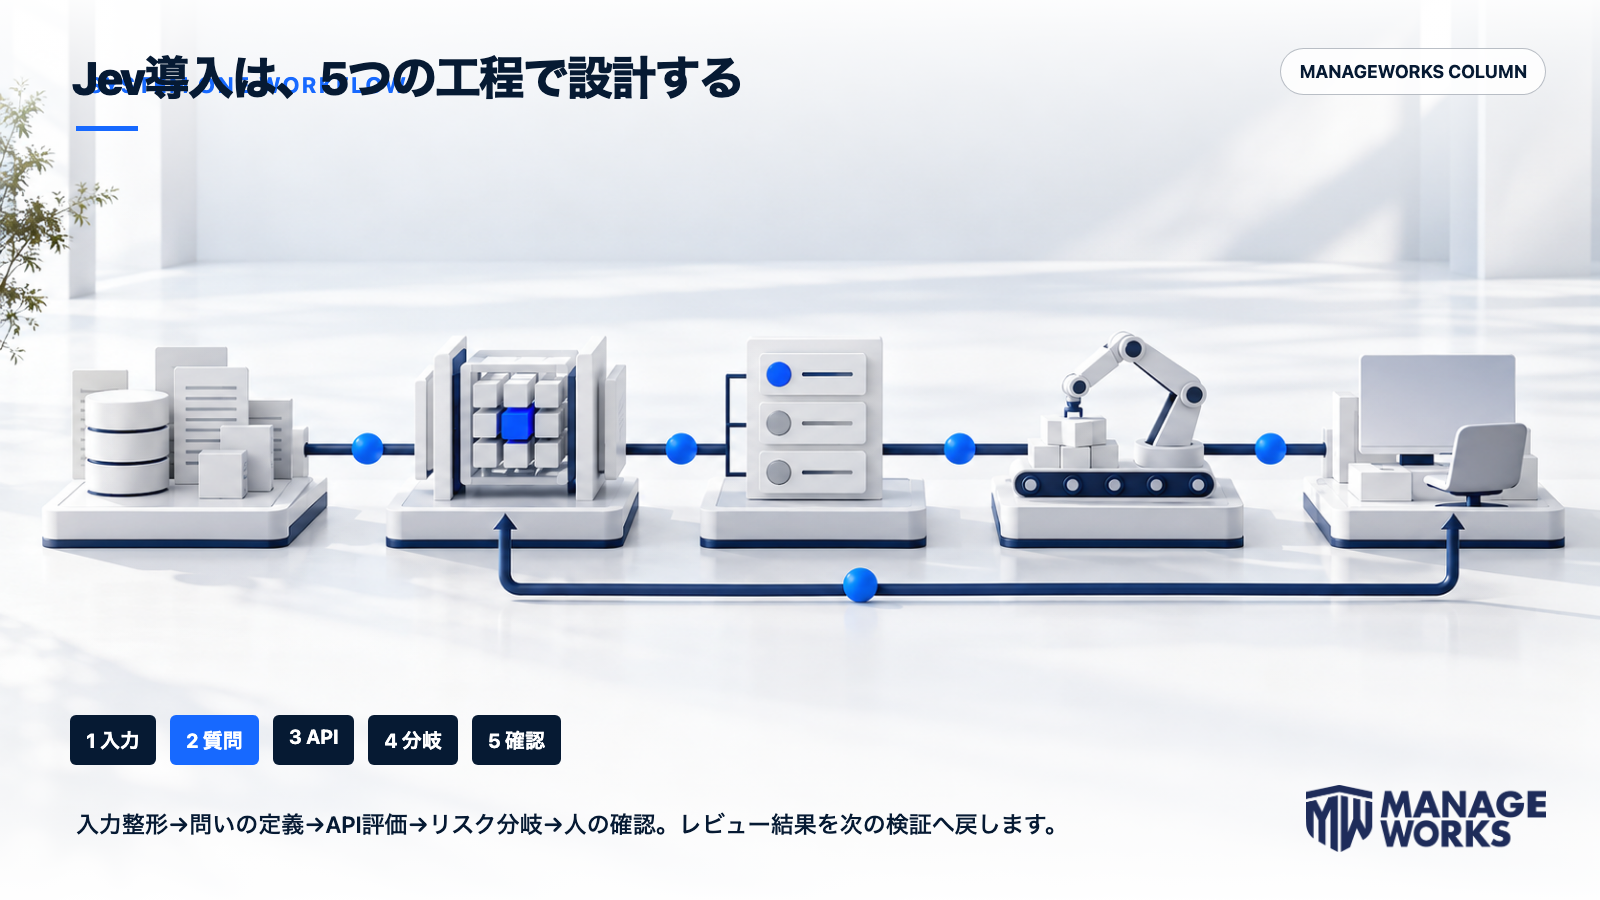
1.early accessへ登録し、APIキーを発行する
TypeSafe AIの公式サイトからearly accessへ申し込み、利用可能になったらConsoleでAPIキーを作成します。キーはソースコードへ直接書かず、環境変数TYPESAFE_API_KEYや秘密情報管理サービスに保存します。ブラウザへ埋め込まず、呼び出しはサーバー側で行います。
2.HTTP APIまたは公式SDKを選ぶ
任意の言語から使う場合は、POST https://api.typesafe.ai/v1/systemoneへBearer認証で送信します。Python 3.10以上なら公式SDKをpip install typesafe-sdkで導入できます。JavaScript/TypeScript向けの公式クライアントSDKも案内されています。公式SDKは既定のリトライ方針を備え、429や529への再試行を扱います。
3.stateとquestionsを作る
stateには判定対象の文字列、オブジェクト、配列を渡します。questionsには任意のIDを付け、Choice、Score、Noulを定義します。問い合わせの部署と緊急性を一度に判定する最小構成は次のようになります。
{
  "state": {"message": "二重請求されています。至急確認してください"},
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "どの担当部署が対応すべきか",
      "criteria": {
        "billing": "請求・支払い・返金",
        "technical": "不具合・接続・技術問題",
        "sales": "料金・契約・新規相談"
      }
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "この問い合わせには緊急性があるか"
    }
  }
}返却されたanswers.department.choiceを振り分け先に使い、probabilitiesとconfidenceを人へ戻す判断に使います。Noulは0〜1の確率を返し、ChoiceとScoreは候補別の確率分布と確信度を返します。
4.Python SDKで呼び出す
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"message": "二重請求されています。至急確認してください"},
        questions={
            "department": Choice(
                instructions="どの担当部署が対応すべきか",
                criteria={
                    "billing": "請求・支払い・返金",
                    "technical": "不具合・接続・技術問題",
                    "sales": "料金・契約・新規相談",
                },
            ),
            "is_urgent": Noul(
                instructions="この問い合わせには緊急性があるか"
            ),
        },
    )

department = response.choices["department"]
urgent = response.nouls["is_urgent"].noul
本番ではタイムアウト、429・529の指数バックオフ、入力ID、モデル名、確率、最終処理、人の修正結果を記録します。個人情報や機密情報を送る場合は、利用規約、プライバシーポリシー、社内規程を確認し、必要な情報だけに絞ります。
使い方のコツ:質問・選択肢・閾値をどう設計するか
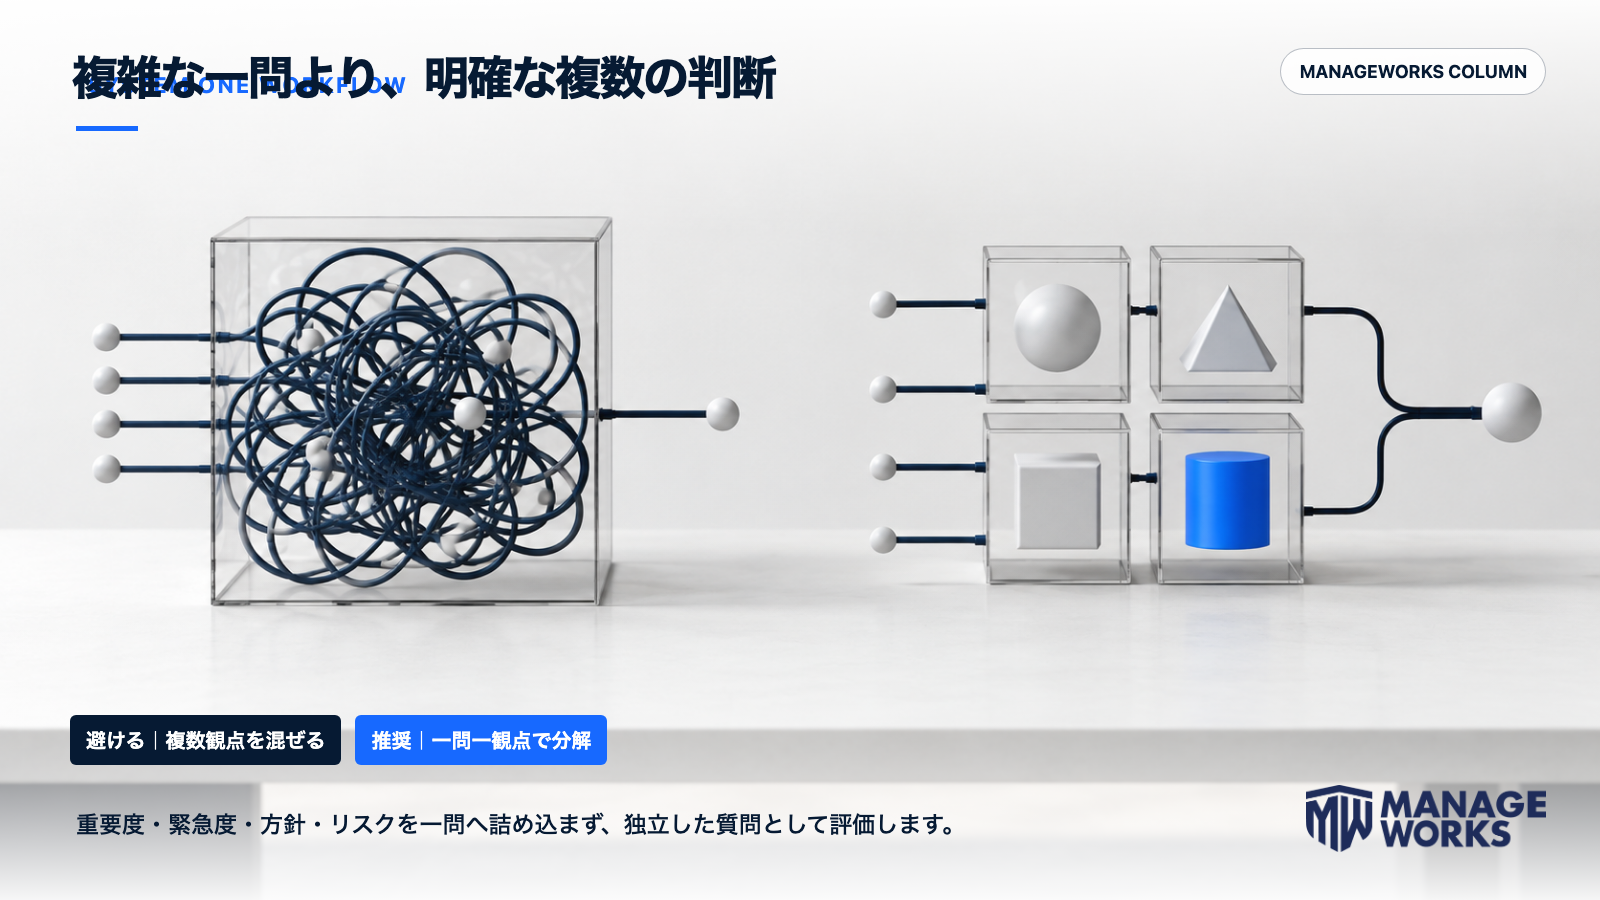
質問は一つの観点だけにする
「この顧客は重要で今すぐ特別対応すべきか」のように、重要度、緊急度、対応方法を混ぜません。「緊急性があるか」「売上影響はどの段階か」「規約上の例外に当たるか」を分け、最後にコードで組み合わせます。
選択肢を重複させず、その他・判断不能を用意する
Choiceの候補説明が重なると確率が分散します。「billing」と「account」の境界など、現場で迷う条件を具体化します。想定外の入力を無理に既存候補へ入れないため、「other」や人へ戻す経路も設けます。
閾値は自社データで決める
公式ドキュメントの数値例をそのまま採用せず、過去データへ正解ラベルを付け、確信度帯ごとの正答率を測ります。誤りの影響が小さい分類は自動化範囲を広げ、返金・契約変更などは高い閾値に加えて本人確認や決定ルールを置きます。
モデル更新前後を同じ評価セットで比較する
jev-latestは更新される可能性があります。正常例、境界例、例外例、誤判定コストの高い例を固定評価セットにし、質問やモデルを変えるたび、精度、校正、処理時間、費用、人の確認率を再測定します。
顧客戦略では「誰に何をするか」の判断基盤として使う
CRMや既存顧客グロースでは、Jevを顧客向け文章の作成者としてではなく、判断基盤として使う可能性があります。問い合わせやアンケートを意図別に分類する、解約理由を複数観点で判定する、接点の優先度を採点する、確信度の低い顧客だけ担当者へ回す、といった設計です。
ただし、モデルを導入しても、改善するKPI、対象顧客、商品・サービス上の原因、現場の役割が曖昧なら成果にはつながりません。まず売上・利益構造と顧客行動を分解し、データと顧客の声から判断基準を作り、その一部をJevで高速化できるか検証します。
MANAGEWORKSの既存顧客グロース支援では、AIツールの導入自体を目的にせず、顧客理解、施策の優先順位、KPI・KDI、商品・接点、現場運用を一つにつなぎます。Jevを含む新しいAIを試す場合も、自動化する判断と人が担う判断を整理し、小さな検証から実装へ進めます。